Отвъд общите уроци за ИИ: Интегриране на ИИ грамотността във финансите и разследването на застрахователни измами
Plamen Djaparov, Nedialko Valkanov, Plamen Miltenoff
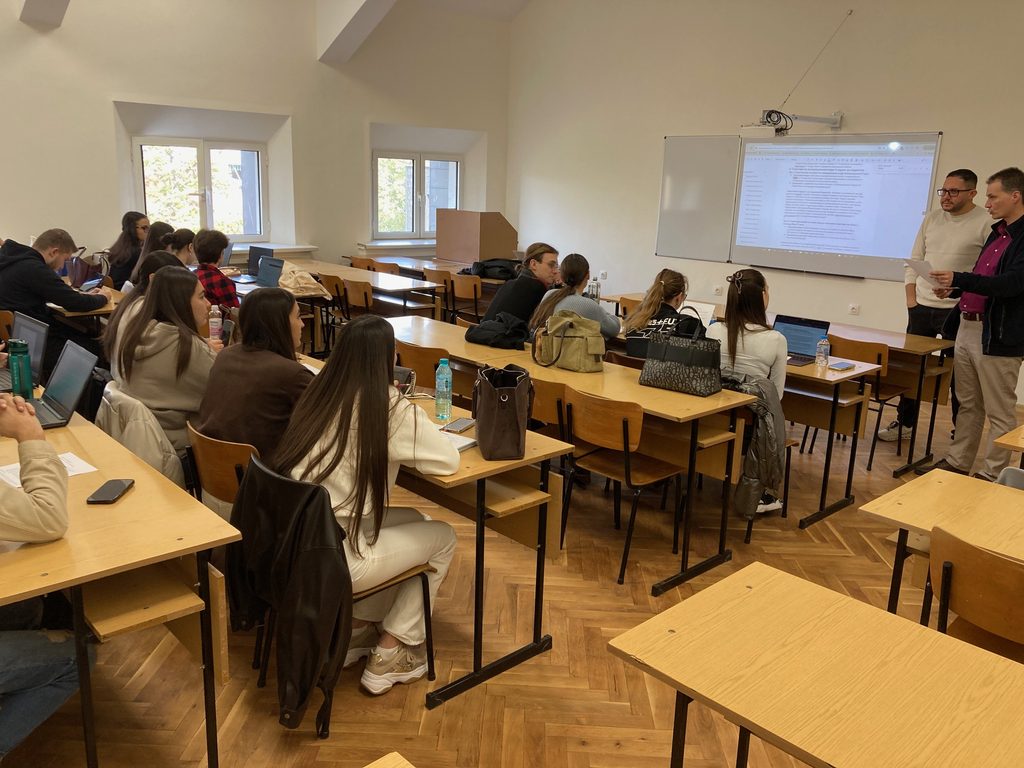
| Teaching university students to write a clever prompt in isolation rarely prepares them for the ethical, legal, and analytical realities of modern professions. True AI competency emerges when students test generative AI against real disciplinary problems—where an unverified citation or a biased prompt carries tangible legal and financial consequences. At the University of Economics – Varna, Bulgaria, an interdisciplinary research and teaching initiative set out to test if small, structured instructional workshops can simultaneously build domain expertise and critical AI literacy. Implemented within the undergraduate finance course Prevention of Financial Violations („Превенция на финансови нарушения“), the project brought together subject-matter experts Nedyalko Valkanov, Ph.D. and Plamen Djaparov, Ph.D. from the Department of Finance, alongside Plamen Miltenoff, Ph.D., MLIS from the Science and Research Institute at the University of Economics – Varna. Designing a Flipped, High-Impact Workshop Rather than sacrificing valuable class time to introductory lectures on either insurance theory or basic AI mechanics, the team adopted a flipped classroom model structured around a focused, 75-to-80-minute small-group workshop on Insurance Fraud („Застрахователни измами“): – Phase 1: Asynchronous Preparation (Flipped Classroom). Before entering the classroom, students reviewed core readings and regulatory frameworks—including the Bulgarian Insurance Code, the Criminal Code, Anti-Money Laundering (AML) provisions, and Article 22 of the EU General Data Protection Regulation (GDPR). They also completed a pre-workshop source-verification task comparing generative AI outputs against authoritative databases. – Phase 2: Applied Claims-Investigation Simulation. During the live session, small student teams stepped into the role of fraud analysts at a fictional insurer. Working with realistic claim dossiers (such as suspected staged vehicle theft, off-season commercial arson, and automated algorithmic risk flags), students first formed an independent human hypothesis before querying an AI assistant. – Structured AI Governance in Action. Students practiced anonymizing personally identifiable information (PII) prior to prompting, applied structured Chain-of-Thought (CoT) templates, and ran counterfactual audits—deliberately feeding one-sided prompts (e.g., “Prove 100% that this claim is fraudulent”) to observe how leading language models suppress exculpatory evidence and exhibit confirmation bias. Every team had to enforce a Human-in-the-Loop standard, verifying statutory citations in primary legal portals before defending a final claim decision. A Dual Approach to Measuring Whether Learning Actually Happened Self-reported enthusiasm after a workshop is not proof of learning. To rigorously evaluate instructional impact, we implemented a dual-assessment pre/post research design combining an Entry Survey (Pre-Test) and an Exit Survey (Post-Test) linked via anonymous student codes: 1. Subjective Self-Efficacy Tracking: Six parallel 5-point Likert items measured shifts in students’ practical confidence across both domains—from distinguishing moral hazard from fraud to redacting PII, structuring iterative prompts, and complying with GDPR Article 22. 2. Objective Cognitive Escalation: Rather than repeating identical multiple-choice questions, the assessments raised cognitive rigor from entry to exit. The Entry Survey tested foundational definitions, whereas the Exit Survey presented complex, multi-variable legal and forensic scenarios—such as applying Benford’s Law to audit suspicious invoices, spotting fabricated Criminal Code articles, and diagnosing algorithmic proxy discrimination—paired with an open-ended metacognitive reflection on live AI errors caught during the workshop. Results Revealed: Analyzing both the cross-sectional responses and the matched longitudinal cohort revealed that substantive learning occurred, but in two distinct pedagogical forms: – Subject-Matter Learning as Applied Transfer: Students entered the workshop well-prepared by the flipped pre-reading, scoring 96.4% on baseline insurance definitions ( 100% on core domain items). On the far more demanding Exit case scenarios, engaged participants achieved 100% accuracy on applied insurance fraud decisions—demonstrating successful transfer from textbook definitions to nuanced forensic and contractual judgment.– AI Literacy as Genuine Skill Acquisition: At entry, high quiz scores masked a severe operational confidence gap. Exactly 50% of respondents rated their practical competence in PII redaction and GDPR Article 22 compliance at just 1– or 2 out of 5 (mean 2.50/5), and nearly a third felt unconfident comparing AI tools (3.12/5). After hands-on practice, GDPR and Human-in-the-Loop confidence recorded the largest gain of the entire study, jumping +1.14 points in the matched cohort (3.00 to 4.14). Engaged students answered 97.8% of applied AI governance questions correctly, and open-ended reflections confirmed that students actively caught live AI hallucinations (such as models conflating a claimant’s residency date with a building’s construction year) and rewrote biased prompts into balanced analytical frameworks.– Pinpointing Next Steps for Instruction: The exit diagnostics also exposed a specific lingering vulnerability: 20% of exit respondents suggested querying another AI model rather than filtering outputs against Bulgarian law when an assistant cited U.S. statutes and private investigators. Identifying this jurisdictional bias gives our team a clear, evidence-based adjustment—adding a dedicated legal-localization checkpoint—for future small-group sessions. Why Embedded AI Competency Matters Treating AI literacy as a standalone technical skill leaves students unprepared for the subtle failure modes of generative models inside specialized fields. When disciplinary faculty and information-literacy researchers co-design flipped, case-based assignments, students learn that AI is neither an infallible oracle nor a shortcut around professional judgment. Embedding prompt engineering, bias auditing, and regulatory compliance directly into finance and insurance coursework ensures that graduates enter the workforce not merely as AI users, but as accountable human decision-makers. | Обучението на студентите как да пишат хитри заявки (промптове) сами по себе си рядко ги подготвя за етичните, правните и аналитичните реалности на съвременните професии. Истинската компетентност за работа с изкуствен интелект (ИИ) се изгражда тогава, когато студентите тестват генеративния ИИ върху реални казуси от своята специалност – там, където непроверен цитат или пристрастна заявка водят до реални правни и финансови последици. В Икономически университет – Варна интердисциплинарна научноизследователска и преподавателска инициатива си постави за цел да провери как малки, структурирани обучителни работилници могат едновременно да развиват експертни познания в конкретната предметна област и критична ИИ грамотност. Реализиран в рамките на бакалавърската дисциплина „Превенция на финансови нарушения“, проектът обедини експертите по темата д-р Недялко Вълканов и д-р Пламен Джапаров от катедра „Финанси“, съвместно с д-р Пламен Милтенов, MLIS от Научноизследователския институт при Икономически университет – Варна. Проектиране на високоефективна работилница по модела на „обърнатата класна стая“ Вместо да губи ценно аудиторно време за уводни лекции по застрахователна теория или базови механизми на ИИ, екипът приложи модела на обърнатата класна стая (flipped classroom), структуриран около фокусирана 75–80-минутна работилница в малки групи на тема „Застрахователни измами“: – Фаза 1: Асинхронна подготовка (обърната класна стая). Преди да влязат в залата, студентите се запознаха с основни учебни текстове и нормативни рамки – включително Кодекса за застраховането, Наказателния кодекс, разпоредбите срещу изпирането на пари (ЗМИП/AML) и чл. 22 от Общия регламент относно защитата на данните (ОРЗД/GDPR). Те изпълниха и предварителна задача за проверка на източници, сравнявайки отговорите на генеративен ИИ с авторитетни бази данни. – Фаза 2: Практическа симулация на разследване на щети. По време на присъствената сесия малки студентски екипи влязоха в ролята на анализатори по разследване на измами във фиктивно застрахователно дружество. Работейки с реалистични досиета за щети (като съмнения за инсценирана кражба на автомобил, палеж на търговски обект извън сезона и автоматизирани алгоритмични сигнали за риск), студентите първо формулираха самостоятелна човешка хипотеза, преди да се допитат до ИИ асистента. – Структурирано управление на ИИ в действие. тудентите упражниха анонимизирането на лични данни (PII) преди въвеждане на заявка, приложиха структурирани шаблони за верижно разсъждение (Chain-of-Thought – CoT) и проведоха контрафактуални одити – умишлено подавайки едностранчиви промптове (напр. „Докажи на 100%, че тази претенция е измама“), за да наблюдават как водещите езикови модели премълчават оневиняващите доказателства и проявяват потвърждаващо пристрастие (confirmation bias). Всеки екип трябваше да приложи стандарта „Човекът в контролния контур“ (Human-in-the-Loop), като проверява нормативните цитати в първични правни портали, преди да защити окончателното си решение по щетата. Двоен подход за измерване дали наистина е настъпило учене Субективният ентусиазъм след дадена работилница не е доказателство за усвоени знания. За да оценим прецизно ефекта от обучението, приложихме изследователски дизайн с двойно оценяване (преди и след обучението), съчетаващ Входна анкета (Pre-Test) и Изходна анкета (Post-Test), свързани чрез анонимни персонални кодове на студентите: 1. Проследяване на субективната увереност (самоефективност): Шест паралелни твърдения по 5-степенна Ликертова скала измериха промените в практическата увереност на студентите и в двете области – от разграничаването на моралния риск от измамата до заличаването на лични данни, структурирането на итеративни заявки и спазването на чл. 22 от ОРЗД. 2. Обективно надграждане на когнитивната сложност: Вместо да повтаря идентични въпроси с избираем отговор, оценяването повиши когнитивните изисквания от входа към изхода. Входната анкета провери познаването на базови определения, докато Изходната анкета представи сложни, многофакторни правни и форензични казуси – като прилагане на Закона на Бенфорд за одит на съмнителни фактури, разпознаване на измислени членове от Наказателния кодекс и диагностициране на алгоритмична дискриминация – съчетани с отворен въпрос за метакогнитивна рефлексия върху реални грешки на ИИ, уловени по време на работилницата. Какво показаха резултатите Анализът както на общите извадки, така и на съпоставената лонгитюдинална кохорта показа, че е постигнато съществено учене, но под две ясно разграничими педагогически форми: – Усвояване на предметното съдържание като приложен трансфер: Студентите влязоха в работилницата добре подготвени благодарение на предварителните материали, постигайки 96,4% успеваемост по базовите застрахователни определения (100% по основните въпроси от предметната област). При значително по-трудните казуси на изхода активно участвалите студенти постигнаха 100% точност при решенията за застрахователни измами – доказателство за успешен пренос от учебникарските дефиниции към задълбочена форензична и договорна преценка. – ИИ грамотността като реално придобиване на умения: На входа високите резултати от теста прикриваха сериозен дефицит в практическата увереност. Точно 50% от респондентите оцениха практическите си умения за анонимизиране на лични данни и спазване на чл. 22 от ОРЗД едва с 1 или 2 от 5 (средна стойност 2,50/5), а близо една трета не се чувстваха уверени при сравняването на различни ИИ инструменти (3,12/5). След практическата работа увереността по отношение на ОРЗД и контрола от страна на човека отбеляза най-големия ръст в цялото изследване – скок с +1,14 пункта в съпоставената кохорта (от 3,00 на 4,14). Активно участвалите студенти отговориха вярно на 97,8% от приложните въпроси за управление на ИИ, а отворените рефлексии потвърдиха, че те успешно са улавяли халюцинации на ИИ в реално време (например модели, които смесват годината на заселване на ищеца с годината на построяване на сградата) и са преформулирали пристрастни заявки в балансирани аналитични рамки. – Очертаване на следващи стъпки за обучението: Изходната диагностика разкри и една конкретна оставаща уязвимост: 20% от участниците на изхода посочиха, че биха се допитали до друг ИИ модел, вместо да филтрират резултатите спрямо българското законодателство, когато асистентът цитира американски закони и частни детективи. Идентифицирането на това юрисдикционно пристрастие дава на екипа ни ясна, основана на данни насока – добавяне на специална контролна точка за правна локализация в бъдещите сесии в малки групи. Защо вградената ИИ компетентност е от ключово значение Третирането на ИИ грамотността като изолирано техническо умение оставя студентите неподготвени за фините грешки на генеративните модели в специализираните професионални сфери. Когато преподавателите по съответната дисциплина и изследователите в областта на информационната грамотност съвместно проектират задачи по модела на обърнатата класна стая и работата по казуси, студентите научават, че ИИ не е нито непогрешим оракул, нито заместител на професионалната преценка. Вграждането на умения за създаване на заявки (prompt engineering), одит за пристрастия и регулаторно съответствие директно в обучението по финанси и застраховане гарантира, че завършилите студенти навлизат на пазара на труда не просто като потребители на ИИ, а като отговорни експерти, вземащи обосновани решения. |