Когато AI може да изпълни заданието, какво всъщност оценяват университетите?
Podcast
Подкаст
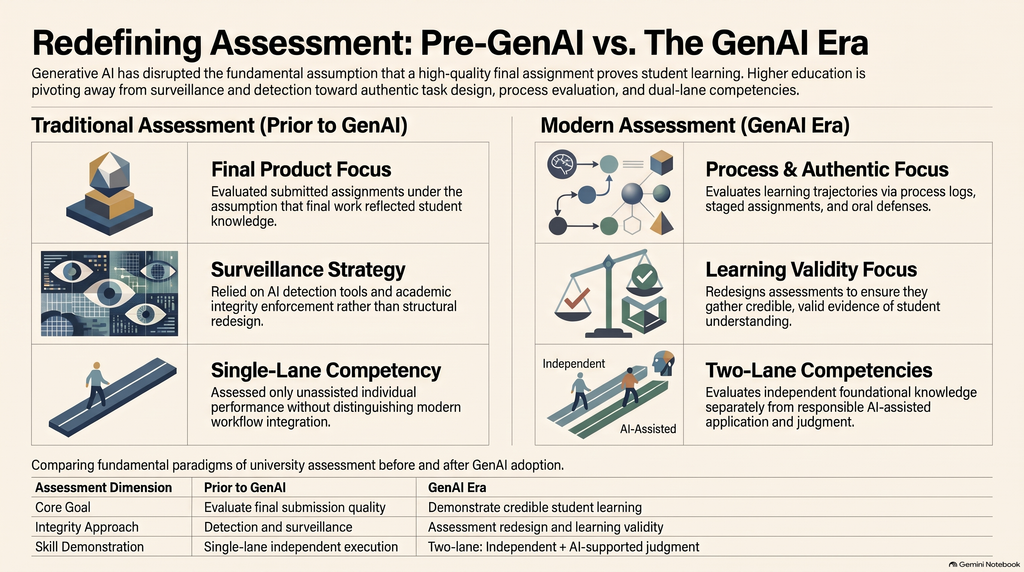
| New research suggests that the future of university assessment depends less on detecting AI use and more on demonstrating genuine learning. Generative AI has changed a fundamental assumption behind university assessment: the work students submit reflects knowledge and abilities. A student may submit an excellent assignment without fully understanding the subject. This raises a question universities can no longer avoid: Are we assessing student learning, or the quality of the work AI helps students produce? A new systematic literature review by Helen Crompton and Diane Burke (2026), published in the International Journal of Educational Technology in Higher Education, provides evidence for reconsidering assessment practices. The authors analyzed 72 empirical studies published between January 2024 and June 2026, covering 24 countries and 20 academic disciplines. Their findings reinforce several arguments we have explored throughout 2026 in the Science & Research Blog. The Real Problem Is Assessment Validity, Not Simply Academic Dishonesty One of the review’s most important conclusions concerns assessment validity. An assessment is valid when it provides credible evidence of the knowledge and abilities it intends to measure. If students can produce convincing answers using AI without demonstrating the intended competencies, the assessment may no longer serve its purpose. This argument connects directly with our earlier posts, Assessment, Academic Integrity, and AI: From Tyler to Dawson and Validity of Assessment Design Lessons. Both emphasized that assessment reform should begin with learning objectives and credible evidence of achievement, rather than surveillance and AI detection. Crompton and Burke’s review strengthens this argument by demonstrating an increasing tendency by researchers across disciplines to examine alternative assessment designs. Three Ways Universities Are Redesigning Assessment The review identifies three major approaches. 1. Assessing the learning process Instead of evaluating only the final submission, educators examine how students develop their work. Portfolios, reflective journals, staged assignments, revision histories, and process documentation provide opportunities to observe learning. For example, a student analyzing consumer behavior might submit the research question, analytical decisions, preliminary results, AI interactions, and explanations of revisions. The goal is to determine whether the student understands the analysis rather than merely presents convincing results. 2. Using authentic, professionally relevant tasks Universities increasingly explore assessments resembling real professional activities, including simulations, case studies, workplace problems, and collaborative projects. In marketing analytics, students might use AI to develop customer segments or evaluate alternative marketing strategies. Assessment would focus on their ability to interpret results, evaluate assumptions, justify decisions, and communicate recommendations. 3. Introducing oral and dialogical assessment Oral defenses, presentations, structured discussions, and interactive questioning allow students to demonstrate understanding and defend their decisions. These approaches connect with our earlier post, From AI Awareness to Assessment Redesign in Higher Education, which proposed process logs, staged assignments, oral components, and explicit evaluation of student judgment. An important qualification remains: none of these approaches automatically guarantees authentic learning. AI can generate reflections and process documentation, while oral assessments introduce accessibility, reliability, and workload challenges. Careful instructional design remains essential. Assessment Must Recognize Two Different Competencies An interesting connection emerges with our April article, From Control to Evidence of Learning: Assessment Strategies in the Age of GenAI. That post examined the University of Sydney’s two-lane assessment model. One lane requires students to demonstrate knowledge independently under secure conditions. The other allows AI assistance while requiring students to explain and justify their work. Crompton and Burke’s findings support the relevance of this distinction. Universities increasingly need evidence of two competencies: what students can accomplish independently and what they can accomplish responsibly with AI. These competencies serve different educational purposes. Independent assessment establishes foundational knowledge, while AI-supported assessment examines professional application, verification, and judgment. Neither should automatically replace the other. AI Can Also Help Educators Assess Learning The review identifies five areas where GenAI supports assessment: creating assignments, preparing students for examinations, grading, making learning visible, and providing feedback. AI can generate practice questions, develop assessment rubrics, simulate professional situations, and provide personalized formative feedback. Yet faster assessment does not necessarily mean better assessment. Our earlier post, AI Grading vs Human Grading: What a Greek Study Tells Us About Assessment, examined differences between AI-generated and teacher-assigned grades. The findings raised questions about reliability, fairness, and the need for human oversight. Crompton and Burke reach a compatible conclusion: AI should support educators’ professional judgment rather than replace it, particularly in consequential assessment decisions. What Does the Research Still Fail to Establish? Despite its contributions, the systematic review exposes important evidence gaps. Most included research uses exploratory, qualitative, or mixed-methods approaches. Relatively few studies test interventions experimentally or examine long-term learning outcomes. Consequently, identifying promising assessment practices does not establish that they consistently improve critical thinking, knowledge retention, or professional competence. The review also has methodological limitations, including restrictive literature searches, uneven geographic representation, inconsistent descriptive counts, and no clearly reported study-level quality appraisal. These limitations matter when translating research findings into institutional policies. Universities need to evaluate assessment redesign, not simply implement new formats because they appear more resistant to AI. What Should Universities Do Next? The practical implications extend beyond individual instructors. Universities should examine whether existing assessments provide credible evidence of learning, distinguish between independent and AI-supported competencies, and develop clear expectations for acceptable AI use. Faculty development should combine AI literacy with assessment literacy. Workshops should help instructors redesign actual assignments, establish rubrics, and evaluate the resulting learning outcomes. Institutions should also pilot redesigned assessments and examine student performance, accessibility, workload, and fairness before expanding successful approaches. This connects with our recent post, From AI Literacy to AI Competence: What Universities Need to Change. Its central argument was that confidence or familiarity with AI does not demonstrate competence. Students must show what they can do. The same principle applies to assessment more broadly. The question in 2026 is back to whether universities can demonstrate students have genuinely learned, rather than use (or misuse) of AI. For faculty, students, and university leaders, the discussion should begin with one practical question: Which of our current assessments still provide convincing evidence of student understanding, and which need to change? | Ново изследване показва, че бъдещето на оценяването във висшето образование зависи не толкова от откриването на използването на AI, колкото от доказването на реално придобити знания и умения. Генеративният изкуствен интелект промени едно основно допускане, върху което традиционно се основава университетското оценяване: че работата, която студентите предават, отразява техните знания и умения. Днес AI може да пише есета, да решава задачи, да създава програмен код, да анализира данни и да подготвя сложни доклади. Студент може да представи отлично изпълнено задание, без да разбира напълно изучавания материал. Това поставя въпрос, който университетите вече не могат да пренебрегват: Оценяваме ли знанията и уменията на студентите, или качеството на работата, която AI им помага да създадат? Нов систематичен обзор на научната литература от Хелън Кромптън и Даян Бърк (2026), публикуван в списанието International Journal of Educational Technology in Higher Education, предоставя научни основания за преосмисляне на практиките за оценяване. Авторите анализират 72 емпирични изследвания, публикувани между януари 2024 г. и юни 2026 г., обхващащи 24 държави и 20 академични дисциплини. Резултатите подкрепят редица аргументи, които разглеждахме през 2026 г. в блога „Наука и научни изследвания“. Истинският проблем е валидността на оценяването, а не само академичната нечестност Един от най-важните изводи на обзора се отнася до валидността на оценяването. Оценяването е валидно, когато предоставя надеждни доказателства за знанията и уменията, които цели да измери. Ако студентите могат да създават убедителни отговори с помощта на AI, без да демонстрират необходимите компетентности, оценяването може да престане да изпълнява предназначението си. Този аргумент е пряко свързан с предишните ни публикации Assessment, Academic Integrity, and AI: From Tyler to Dawson и Validity of Assessment Design Lessons. И в двете подчертахме, че реформата на оценяването трябва да започне от учебните цели и надеждните доказателства за тяхното постигане, а не от наблюдението на студентите и откриването на използването на AI. Обзорът на Кромптън и Бърк подкрепя този аргумент, като показва, че изследователи от различни дисциплини все по-често проучват алтернативни модели за оценяване. Три начина, по които университетите променят оценяването Обзорът идентифицира три основни подхода. 1. Оценяване на процеса на учене Вместо да оценяват единствено крайния резултат, преподавателите проследяват как студентите разработват своята работа. Портфолиа, рефлексивни дневници, поетапни задания, история на редакциите и документиране на работния процес предоставят възможности за наблюдение на ученето. Например студент, който анализира потребителското поведение, може да представи изследователския въпрос, взетите аналитични решения, предварителните резултати, взаимодействията с AI и обяснения за направените промени. Целта е да се установи дали студентът разбира анализа, а не само дали представя убедителни резултати. 2. Използване на автентични задачи, свързани с професионалната практика Университетите все по-често изследват форми на оценяване, които наподобяват реални професионални дейности, включително симулации, казуси, практически проблеми и екипни проекти. В обучението по маркетингова аналитика например студентите могат да използват AI, за да разработят потребителски сегменти или да сравнят алтернативни маркетингови стратегии. Оценяването ще се съсредоточи върху способността им да интерпретират резултатите, да проверяват допусканията, да обосновават решенията си и да представят препоръки. 3. Въвеждане на устно и диалогично оценяване Устните защити, презентациите, структурираните дискусии и интерактивните въпроси позволяват на студентите да демонстрират разбиране и да защитават решенията си. Тези подходи се свързват с предишната ни публикация From AI Awareness to Assessment Redesign in Higher Education, в която предложихме документиране на работния процес, поетапни задания, устни компоненти и изрично оценяване на способността на студентите да правят обосновани преценки. Остава едно важно уточнение: нито един от тези подходи не гарантира автоматично автентично учене. AI може да генерира рефлексии и документация на работния процес, а устните изпитвания поставят въпроси, свързани с достъпността, надеждността на оценяването и натоварването на преподавателите. Внимателният педагогически дизайн остава решаващ. Оценяването трябва да отчита два различни вида компетентности Интересна връзка се открива с нашата априлска публикация From Control to Evidence of Learning: Assessment Strategies in the Age of GenAI. В нея разгледахме двупистовия модел за оценяване на Университета в Сидни. При единия подход студентите трябва да демонстрират знания самостоятелно, в контролирана среда. При другия използването на AI е разрешено, но студентите трябва да обяснят и обосноват своята работа. Резултатите на Кромптън и Бърк подкрепят значението на това разграничение. Университетите все повече се нуждаят от доказателства за два вида компетентности: какво студентите могат да постигнат самостоятелно и какво могат да постигнат отговорно с помощта на AI. Тези компетентности имат различни образователни цели. Самостоятелното оценяване установява фундаменталните знания, докато оценяването с AI подкрепа проверява професионалното приложение, способността за проверка и обоснованата преценка. Нито единият подход трябва автоматично да замества другия. AI може да помага и на преподавателите да оценяват ученето Обзорът идентифицира пет области, в които GenAI подпомага оценяването: създаване на задания, подготовка на студентите за изпити, оценяване, проследяване на напредъка в ученето и предоставяне на обратна връзка. AI може да генерира тренировъчни въпроси, да разработва рубрики за оценяване, да симулира професионални ситуации и да предоставя персонализирана формираща обратна връзка. Но по-бързото оценяване не означава непременно по-добро оценяване. В предишната ни публикация AI Grading vs Human Grading: What a Greek Study Tells Us About Assessment разгледахме различията между оценките, поставяни от AI, и тези на преподавателите. Резултатите повдигнаха въпроси за надеждността, справедливостта и необходимостта от човешки контрол. Кромптън и Бърк достигат до сходен извод: AI трябва да подпомага професионалната преценка на преподавателите, а не да я замества, особено при решения с важни последици за студентите. Какво все още не успяват да докажат научните изследвания? Въпреки приноса си систематичният обзор разкрива съществени пропуски в наличните научни доказателства. Повечето включени изследвания използват проучвателни, качествени или смесени методи. Сравнително малко изследвания проверяват ефективността на интервенциите експериментално или проследяват дългосрочните резултати от ученето. Следователно идентифицирането на обещаващи практики за оценяване не доказва, че те последователно подобряват критичното мислене, дългосрочното запазване на знанията или професионалните компетентности. Самият обзор има методологични ограничения, включително рестриктивна стратегия за търсене на литература, неравномерно географско представителство, несъответствия в описателните статистически данни и липса на ясно представена оценка на качеството на отделните изследвания. Тези ограничения са важни при превръщането на научните резултати в институционални политики. Университетите трябва да оценяват ефективността на промените в оценяването, а не просто да въвеждат нови формати, защото изглеждат по-устойчиви на използването на AI. Какво трябва да направят университетите? Практическите последици надхвърлят работата на отделния преподавател. Университетите трябва да проверят дали съществуващите форми на оценяване предоставят надеждни доказателства за ученето, да разграничат самостоятелните компетентности от тези, демонстрирани с AI подкрепа, и да определят ясни правила за допустимото използване на AI. Развитието на преподавателските компетентности трябва да съчетава AI грамотност с грамотност в областта на оценяването. Обученията следва да подпомагат преподавателите при преработването на реални задания, разработването на рубрики и оценяването на постигнатите учебни резултати. Институциите трябва също да изпробват нови модели за оценяване и да анализират постиженията на студентите, достъпността, натоварването и справедливостта, преди да разширят успешните практики. Това се свързва с неотдавнашната ни публикация From AI Literacy to AI Competence: What Universities Need to Change. Основният ѝ аргумент беше, че увереността или познаването на AI не доказват компетентност. Студентите трябва да демонстрират какво действително могат да правят. Същият принцип важи и за оценяването като цяло. Въпросът вече не е само дали студентите използват AI. Въпросът е дали университетите могат да докажат какво студентите действително са научили. За преподавателите, студентите и университетските ръководства дискусията трябва да започне с един практически въпрос: Кои от сегашните ни форми на оценяване все още предоставят убедителни доказателства за разбирането на студентите и кои трябва да променим? |